 Dinox AI笔记
剪藏
用 dino clip 在自己电脑上把网页、公众号文章、知乎、小红书、B 站和 YouTube 视频、播客剪藏成 Dinox 笔记。
dino clip 在你自己的电脑上抓取链接:用你的网络、你的 IP、你保存的登录状态打开网页,把正文、图片、视频转成一条 Dinox 剪藏笔记。服务器抓不到的页面(需要登录、限制地区、反爬严格),在本机往往能抓到。
支持任意网页,以及 X、微信公众号、知乎、小红书、微博、B 站、YouTube、抖音、播客等平台。
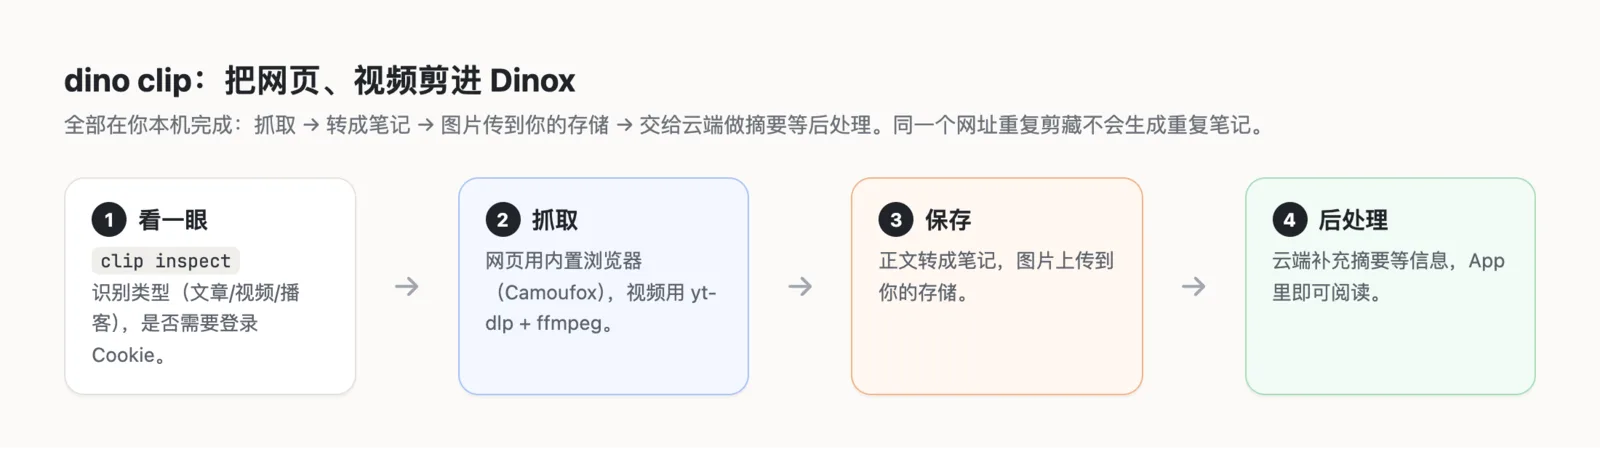
案例:把一篇文档剪藏下来
先检查一下这个链接
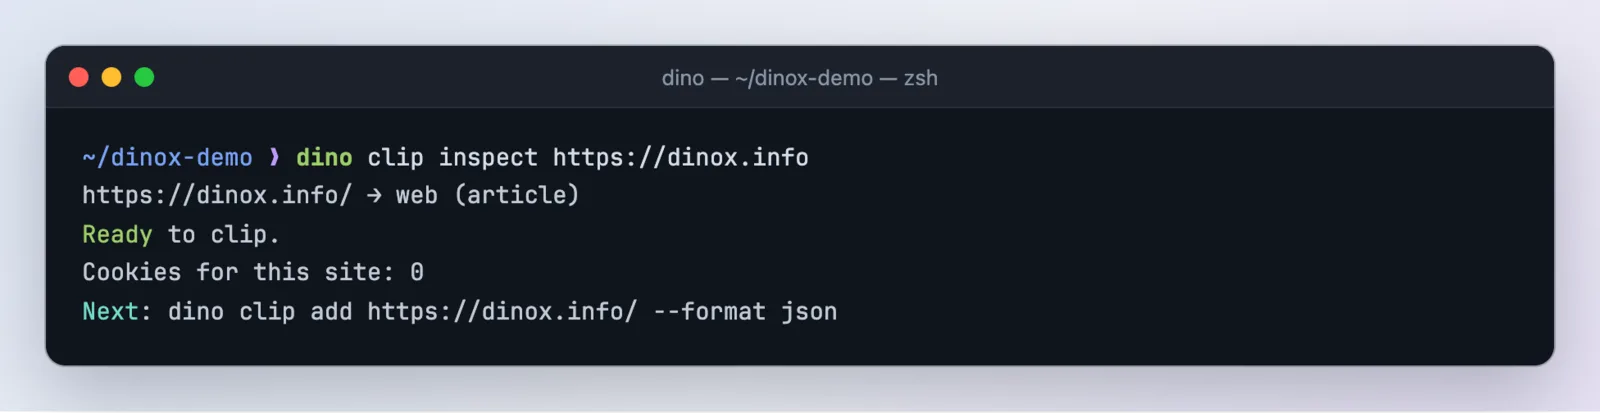
dino clip inspect https://dinox.infoinspect 不会真的抓取,只告诉你:这是哪个平台、能不能在本机剪藏、浏览器和工具装好了没有、需不需要登录 cookie,以及下一步该运行什么命令。
第一次用:装好抓取浏览器
本机剪藏使用一个专门的浏览器(Camoufox,约 1.3 GB,支持断点续传)。只需装一次:
dino clip setup          # 下载浏览器
dino clip setup --check  # 只检查,不下载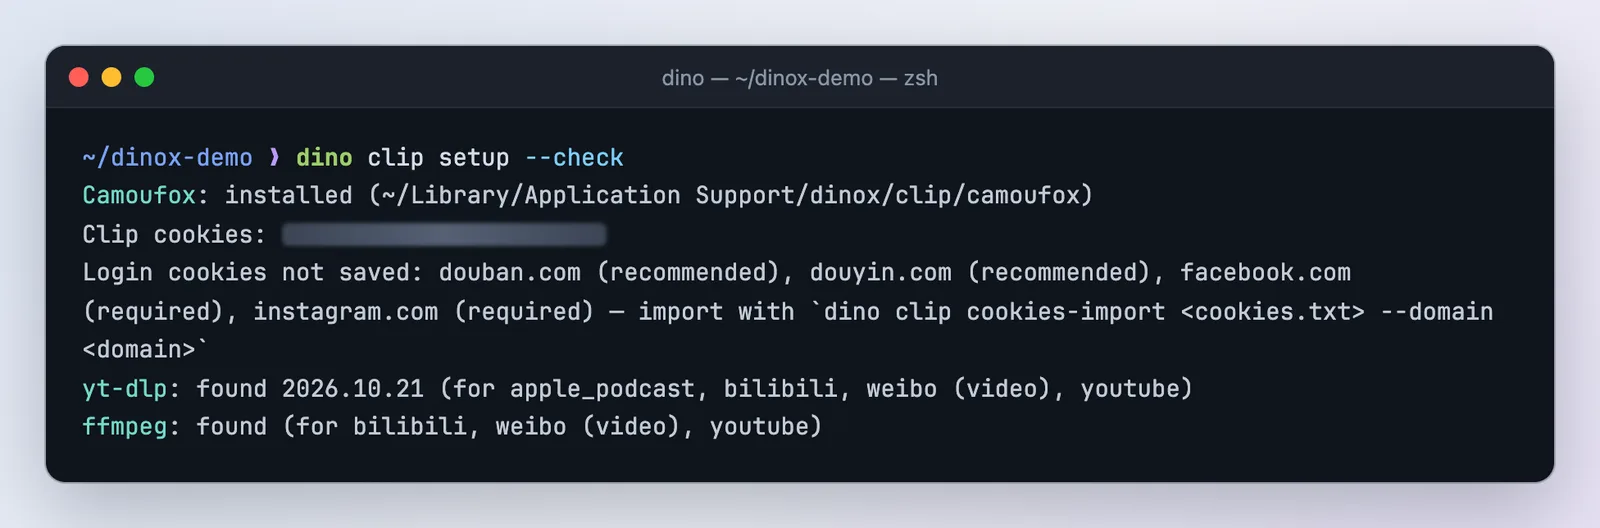
剪藏 B 站、YouTube 等视频还需要 yt-dlp 和 ffmpeg,可以用 Homebrew 等包管理器安装。
剪藏
dino clip add https://dinox.info/guides/mobile/agent-skills-memory \
  --title "示例:剪藏一篇 Dinox 文档" --tags 文档示例 --progress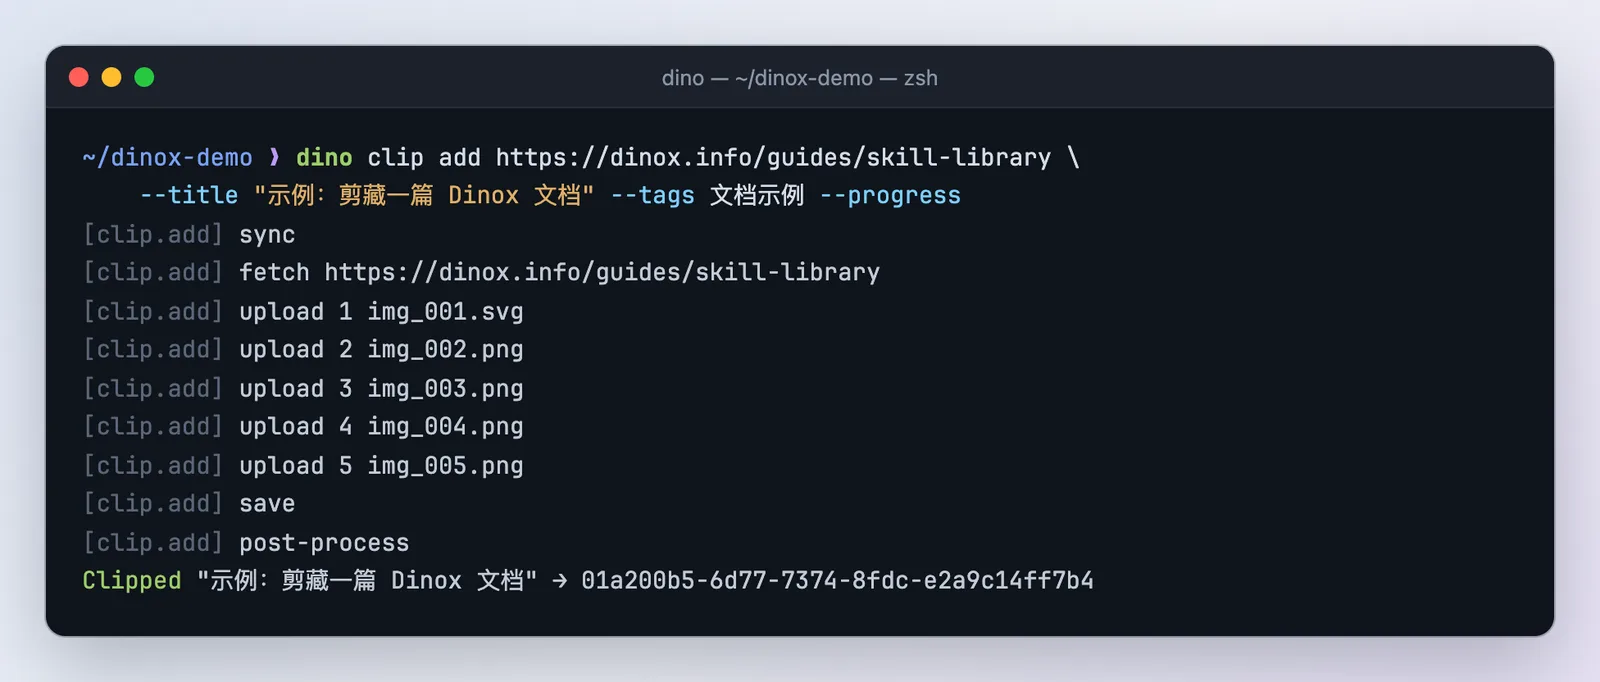
看看结果
dino note detail <笔记ID> --content md --max-chars 160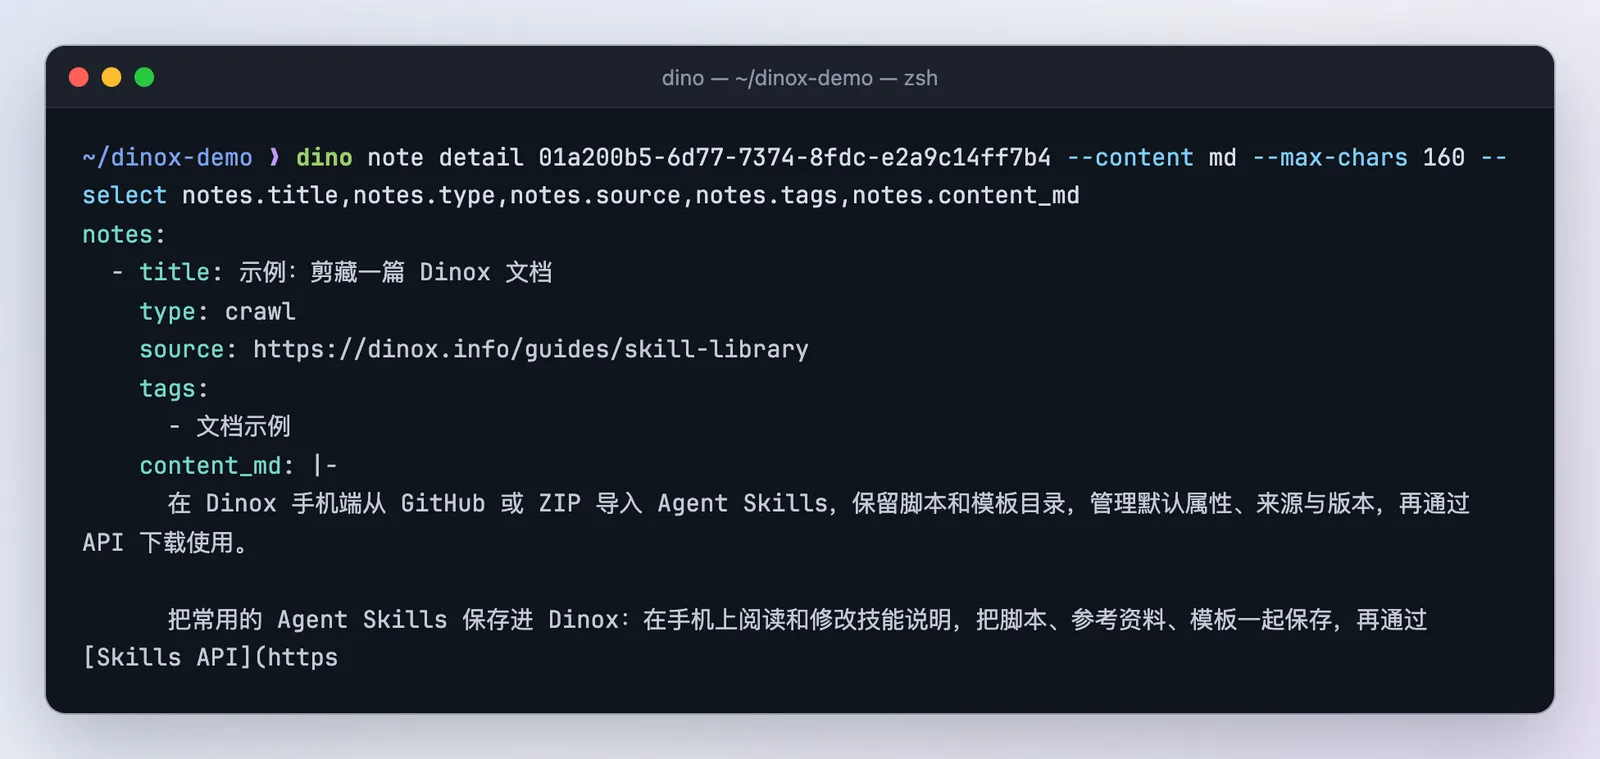
打开 App,这条剪藏笔记就在笔记列表里,图片都已经转存到你的存储中。
常用参数
| 参数 | 作用 |
|---|---|
--title / --tags / --boxes | 覆盖标题、加标签、放进文件夹 |
--dry-run | 只抓取并转换,返回 Markdown,不上传也不保存(不需要登录) |
--proxy <地址> | 抓取时使用的 HTTP 代理(默认读 HTTPS_PROXY / ALL_PROXY) |
--timeout <毫秒> | 页面抓取超时,默认 3 分钟 |
--allow-duplicate | 同一个链接再剪藏一次 |
同一个链接默认只剪藏一次:再运行 clip add 会直接返回已有的笔记(duplicate: true),不会重复抓取。想重新抓取,加 --allow-duplicate。云端后处理(补全标题标签摘要、图片文字识别、音视频转写)如果没完成,可以用 dino clip process <笔记ID> 再请求一次。
需要登录的网站
豆瓣、抖音、Facebook、Instagram 等网站需要登录后才能看到完整内容。把浏览器里的 cookie 导出成 cookies.txt(Netscape 格式),再导入给 dino:
dino clip cookies-import ./cookies.txt --domain douban.com
dino clip cookies-list      # 只显示域名和 cookie 名,不显示值
dino clip cookies-remove douban.com
dino clip setup --check 会列出哪些网站推荐或必须导入 cookie。
cookie 等同于你的登录状态,保存在本机的 Dinox 数据目录里。不要把 cookies.txt 发给别人,也不要提交到代码仓库。